
En el primer article d'aquesta sèrie vàrem muntar l'esquelet de la xarxa neuronal. En el segon vàrem obrir la caixa negra de `conv1` i `conv2`: què és una convolució i com un filtre aprèn a detectar patrons visuals.
Ens queden dues peces per explicar, i són just les que solen generar més dubtes perquè ja no es poden "veure" tan fàcilment com els filtres: el pooling (`self.pool`) i les capes denses (`fc1`, `fc2`). Tanquem amb elles la sèrie.
1. Què és el pooling?
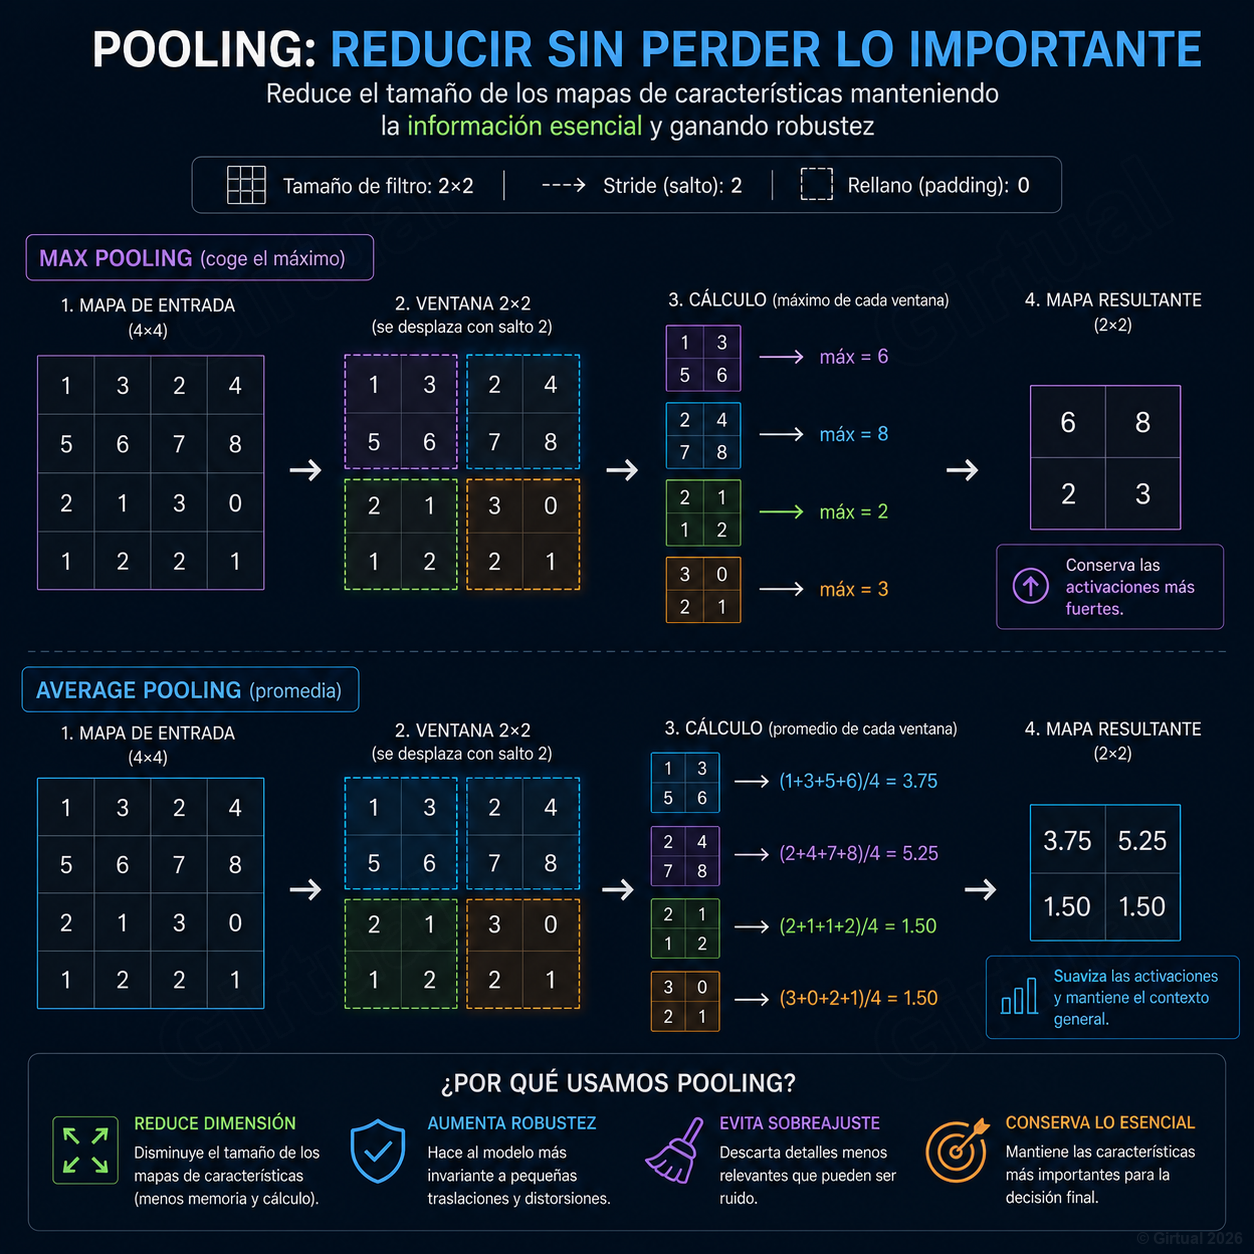
El pooling és una operació que s'aplica just després d'una convolució. La seva feina és senzilla: reduir la mida del mapa d'activació quedant-se només amb la informació més rellevant de cada zona.
Pensa en el pooling com si fessis una foto de resolució alta i la comprimissis a propòsit, quedant-te només amb l'essencial de cada bloc de píxels, en comptes d'intentar conservar-ho tot.
Com funciona: una finestra lliscant
Igual que la convolució, el pooling es mou per la imatge amb una finestra, però sense multiplicacions ni filtres complexos: simplement agafa el valor més representatiu de cada zona.
| Tipus | Què fa |
|---|---|
| MaxPooling | Agafa el valor màxim de la finestra |
| AvgPooling | Agafa el valor mitjà de la finestra |
Exemple numèric
Imagina aquest tros de mapa d'activació (valors 2×2):
[1, 3]
[4, 2]
Un MaxPooling de 2×2 sobre aquest bloc retorna un únic valor: `4` — el més alt dels quatre.
Un AvgPooling de 2×2 sobre el mateix bloc retorna `2.5` — la mitjana de (1+3+4+2)/4.
En el nostre model fem servir MaxPooling perquè, per classificar imatges, ens sol interessar més "on hi ha una activació forta d'aquest patró?" que no pas "quina és la mitjana d'aquesta zona?" — una vora molt marcada en una cantonada de la finestra és més informativa que diluir-la amb la mitjana de la resta.
En el nostre codi
# Definim el pooling una sola vegada a __init__, i el reutilitzem
# tant després de conv1 com després de conv2.
self.pool = nn.MaxPool2d(2, 2)   # finestra de 2x2, es queda amb el valor més alt de cada una
# A forward, el pooling s'aplica sempre just després de la convolució + ReLU:
x = self.pool(torch.relu(self.conv1(x)))
Exemple concret amb números reals: si la imatge que entra fa 32×32 píxels, després d'aquesta línia el resultat fa 16×16. En passar una altra vegada per `conv2` i `self.pool` de nou, passem de 16×16 a 8×8. Per això en el primer article la capa densa esperava `32 * 8 * 8` valors d'entrada — el `8×8` ve exactament d'aplicar pooling dues vegades sobre una imatge de 32×32.
2. Per què el pooling importa (no és només "per estalviar espai")
- Redueix la mida → menys números a processar en les següents capes, entrenament més ràpid.
- Es queda amb el que és important → descarta detalls poc rellevants i conserva els patrons principals de cada zona.
- Fa el model més robust → si en una fotografia la gallina està una mica més a la dreta que en una altra, el pooling ajuda a fer que el model la reconegui igual, perquè no depèn de la posició exacta de cada píxel.
- Ajuda a evitar overfitting → en simplificar la informació, és més difícil que el model "memoritzi" detalls irrellevants de les fotos d'entrenament en comptes d'aprendre el patró general.
3. Les capes denses: on es pren la decisió final
Després de les convolucions i el pooling, ja no tenim una imatge en el sentit habitual — tenim un vector de números, una llista llarga que resumeix el que la xarxa neuronal ha detectat. Una cosa com:
[0.1, 2.3, 0.0, 5.4, 1.2, 0.7, ...]
Aquí és on entren les capes denses (també anomenades *fully connected*, d'aquí el nom `fc1`, `fc2`):
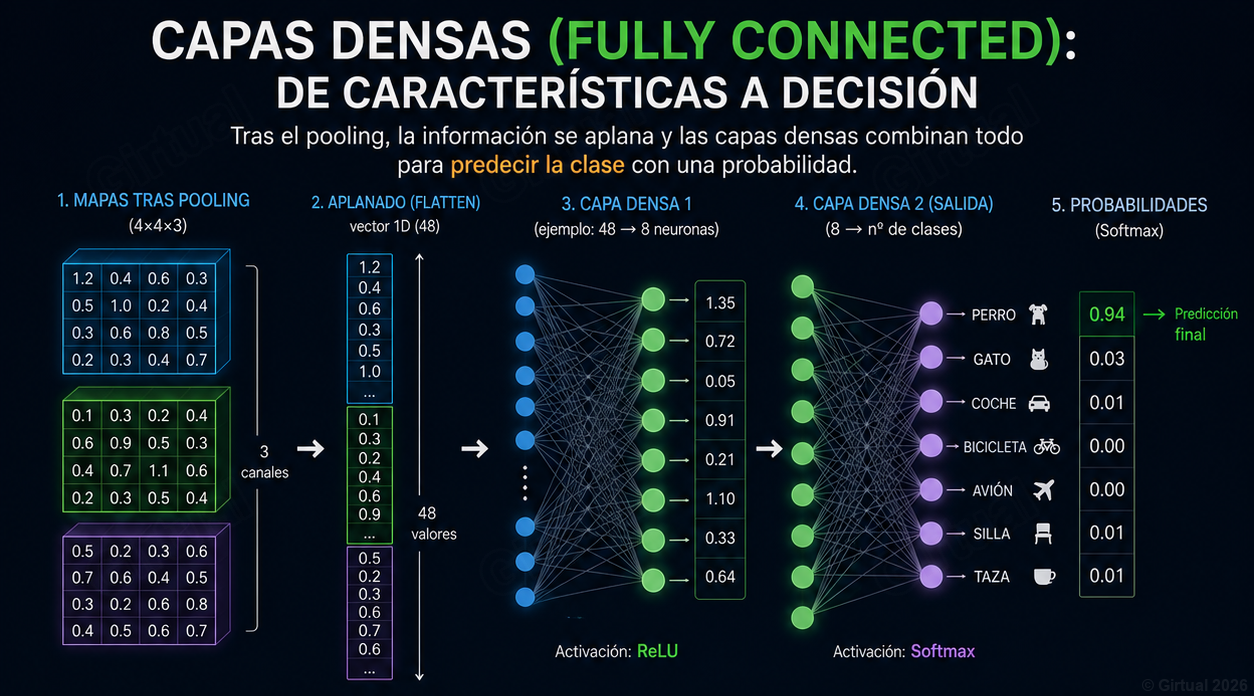
self.fc1 = nn.Linear(32 * 8 * 8, 128)   # de 2048 valors d'entrada a un vector de 128
self.fc2 = nn.Linear(128, num_classes)  # de 128 valors a una neurona per classe
`nn.Linear(entrada, sortida)` connecta cada número d'entrada amb cada neurona de sortida — d'aquí el nom de "densa": no se salta cap connexió possible, a diferència de la convolució, que només mira una finestra petita a la vegada.
Per què es parla menys de les capes denses que dels filtres?
És una pregunta molt raonable, i té una resposta clara: perquè no es poden "veure" tan fàcilment. Un filtre de convolució és una imatge petita — el pots dibuixar i mirar. Una capa densa, en canvi, treballa amb un vector abstracte de números, sense cap estructura espacial (no hi ha "a dalt", "a baix" o "veí" en una llista de 2048 números). No hi ha una forma tan directa de dibuixar "què està pensant" aquesta capa.
Així i tot, és precisament aquí om es pren la decisió. El procés, en resum:
- Les capes convolucionals detecten patrons bàsics: vores, corbes, textures.
- Les capes denses combinen aquests patrons. De forma simplificada: *"si hi ha una cosa rodona amb dues línies verticals al costat, probablement sigui un ull"*.
- Si a més es combinen activacions relacionades amb cap, bec i plomes: *"amb tot això junt, és molt probable que sigui una gallina"*.
4. El vector d'embedding: la "petjada digital" de la imatge
El resultat de `fc1` — aquest vector de 128 números — té un nom propi: se'n diu embedding. És una representació numèrica i abstracta de la imatge, calculada per la xarxa.
Si ja coneixes Qdrant (una base de dades vectorial que farem servir en altres projectes d'aquesta web), això et sonarà familiar: és exactament el mateix concepte. Quan entrenes el model, imatges similars (dues fotos de gallines diferents, per exemple) acaben generant vectors d'embedding similars entre si — igual que a Qdrant desem vectors per poder comparar significats, aquí el model genera vectors per poder comparar imatges. L'última capa (`fc2`) fa servir aquest vector per decidir la classe final, gairebé com si consultés internament una petita base de dades vectorial.
# outputs és el resultat final de passar la imatge per TOT el model (fc2 inclosa).
# outputs.shape seria una cosa com [1, num_classes] -> una puntuació per classe.
# torch.max ens dona l'índex de la classe amb la puntuació més alta:
# l'"1" indica que busquem el màxim al llarg de la dimensió de les classes.
_, predicted = torch.max(outputs, 1)
Un matís important sobre la mida d'aquest vector: el nombre de dimensions de l'embedding no és fix, el decideixes tu quan defineixes la capa. Si en el teu model posessis `nn.Linear(32 * 8 * 8, 128)`, l'embedding tindria 128 dimensions. Si en un altre projecte fessis servir `nn.Linear(16 * 32 * 32, 64)`, en tindria 64. No hi ha un nombre "correcte" universal — és un paràmetre de disseny més, com decidir quantes línies fer servir per resumir alguna cosa: més dimensions poden capturar matisos més fins, però també fan el model més pesat d'entrenar.
5. El pipeline complet, d'un cop d'ull
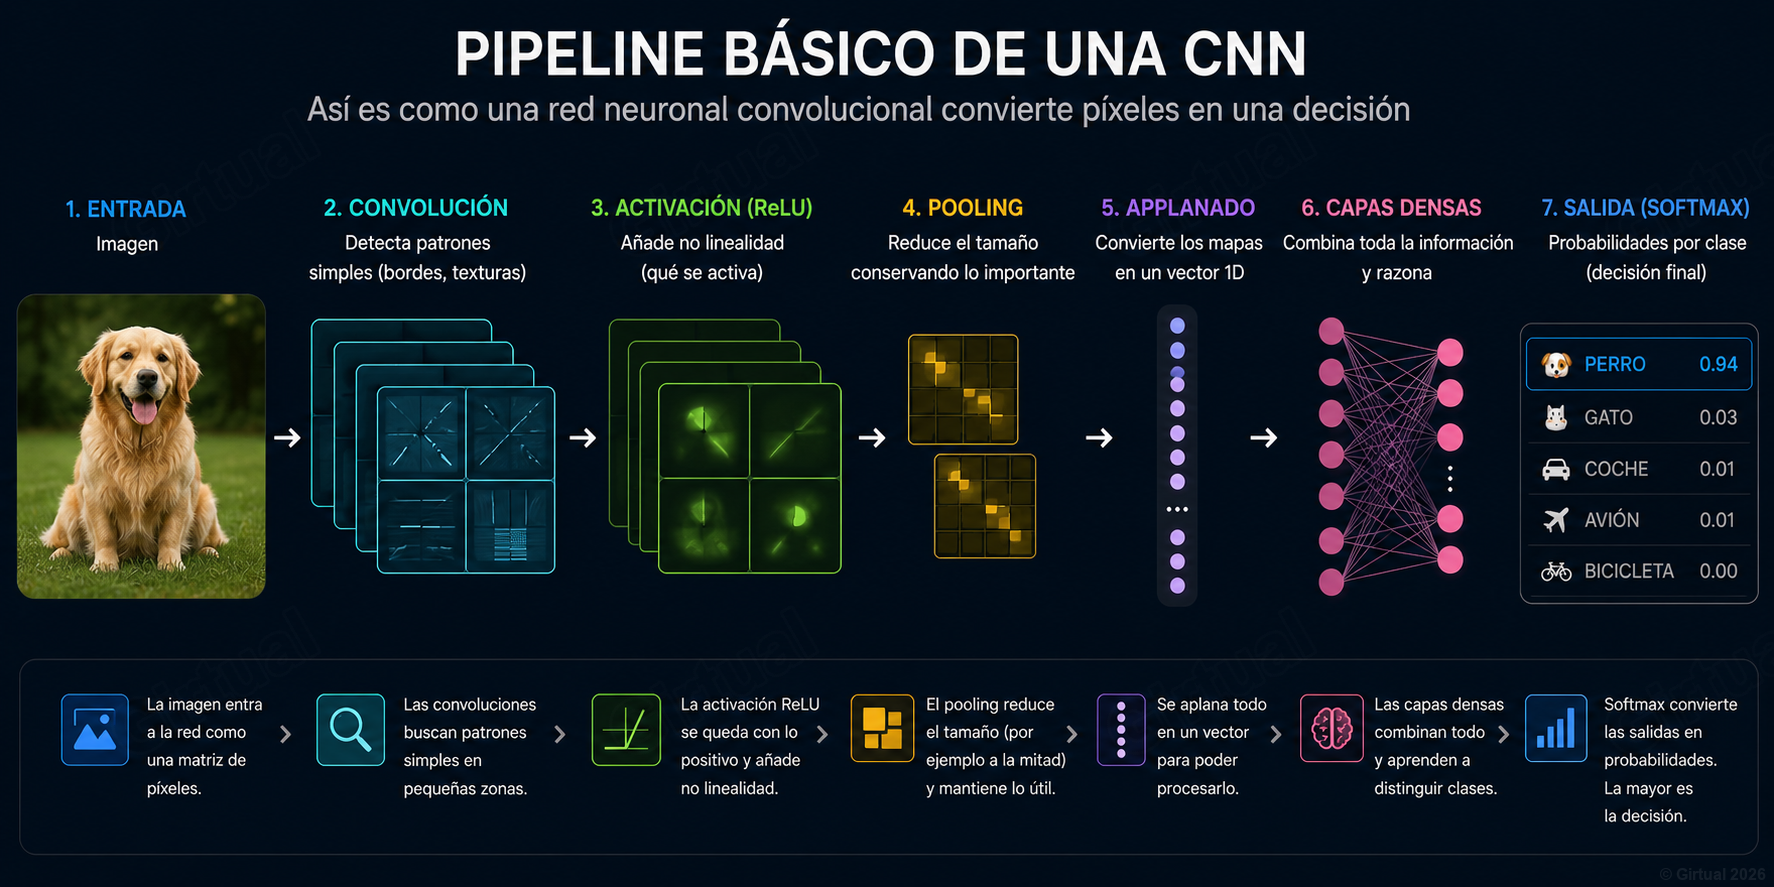
El pipeline general de processament de la nostra xarxa neuronal es resumeix en les etapes següents:
| Etapa | Què fa | Analogia |
|---|---|---|
| Convolució (`conv1`, `conv2`) | Detecta patrons visuals bàsics: vores, textures, corbes | Un detectiu buscant pistes a l'escena |
| Pooling (`pool`) | Redueix mida, es queda amb el més rellevant de cada zona | Resumir l'escena per telèfon, sense descriure cada píxel |
| Aplanat (`view`) | Converteix el resultat en una llista de números | Desfilar una manta doblegada en un sol fil |
| Capes denses (`fc1`, `fc2`) | Combinen els patrons detectats i decideixen la classe final | El detectiu en cap unint totes les pistes i donant un veredicte |
6. Tancament de la sèrie
Amb això completem el recorregut de les tres entregues:
- Primera part: l'estructura del projecte i l'arquitectura completa de la xarxa.
- Segona part: què és una convolució i com es veuen els filtres, tant dissenyats a mà com apresos pel model.
- Tercera part: com el pooling simplifica la informació, i com les capes denses la combinen per prendre la decisió final.
D'aquí a un model entrenat de veritat i funcionant en producció hi ha principalment una diferència: repetir aquest mateix flux milers de vegades, amb dades reals i etiquetades, deixant que l'optimitzador (`Adam`, del primer article) vagi ajustant a poc a poc cada filtre i cada pes de les capes denses fins que les prediccions s'aproximin a la realitat. Aquest procés d'entrenament a fons — quant triga, com se sap quan cal parar, quins errors típics apareixen — el deixem per a una pròxima sèrie.
Article elaborat a partir de proves reals sobre infraestructura pròpia de ReparamiPC/Girtual (Girona).

